목차
9월 15일, TypeSafe AI가 ’Jev’라는 새 모델을 공개했어요. 최근 개발자 커뮤니티에서 많은 이야기가 오가고 있는데, 그 이유는 이 모델이 텍스트를 전혀 생성하지 않기 때문입니다. 평소 쓰는 ChatGPT, Claude, Gemini는 한 글자 한 글자씩 타이핑하듯 답변을 내놓지만 Jev는 전혀 달라요. 프로그램 데이터와 보기가 정해진 몇 가지 질문을 던져주면, 모든 질문의 답과 그 확률을 한 번에 통째로 반환합니다.
비유하자면 일반 LLM이 논술 답안지를 작성하고 있다면, Jev는 OMR 답안지에 컴퓨터용 사인펜으로 마킹만 하는 셈이에요. 이 모델이 무엇이고, 어떻게 쓰고, 왜 빠르고, 사람들이 이걸로 무엇을 만들었으며 어떤 함정이 있는지 낱낱이 풀어볼게요.
그렇다면 이걸 만든 사람은 누구일까요?
창업자 이름은 디오고 알메이다(Diogo Almeida)로, 이전에 OpenAI와 Google Brain에 몸담았던 인물입니다. InstructGPT, RLHF, ChatGPT, GPT-4 개발에 모두 직접 참여했죠. 대규모 언어 모델에게 말을 가르치고 사람과 대화하게 길들였던 장본인이, 정작 독립해서는 ’말을 하지 않는 모델’을 들고나온 게 참 흥미롭습니다.
그는 릴리즈 노트에서 “모델의 대화 능력은 진작 사람을 뛰어넘었는데, 우리가 기대했던 자동화는 대체 어디로 갔는가?“라고 반문했어요. 회사는 DCVC가 리드한 시드 라운드에서 4,000만 달러를 유치했고 팀은 샌프란시스코에 있습니다.
이름의 유래
이들은 이런 종류의 모델을 ‘System 1(시스템 1)’ 모델이라고 부릅니다. 대니얼 카너먼의 명저 『생각에 관한 생각』에서 따온 개념이죠. 시스템 1은 직관적이고 빠르게 판단하는 인간 뇌의 무의식적 사고 체계예요. 이들은 소프트웨어 안에서 일어나는 수많은 결정(예: ‘이건 어떤 카테고리인가?’, ‘얼마나 긴급한가?’)이 바로 이런 문제라고 보았습니다. 그런데 지금까지 우리는 비싼 돈을 주고 느린 심사숙고형(시스템 2) 대형 모델을 불러다 답을 맞히게 해왔던 거죠.
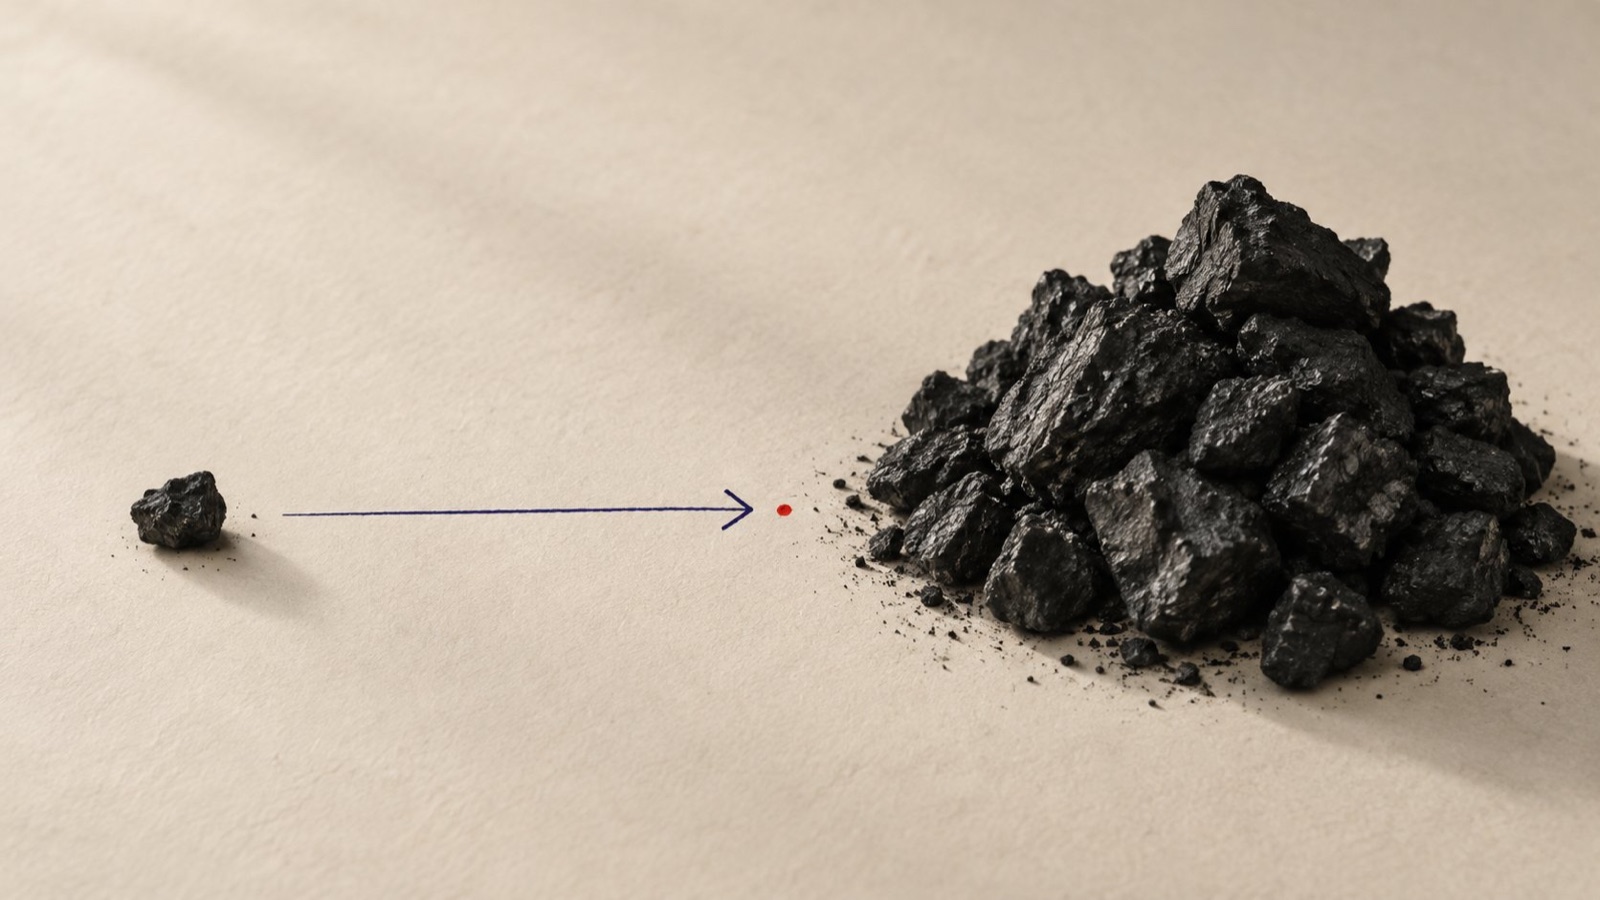
’Jev’라는 이름은 경제학자 윌리엄 제번스(Jevons)에서 따왔습니다. ’제번스의 역설’은 증기기관의 석탄 효율이 좋아질수록 석탄 소비가 줄어드는 게 아니라 오히려 폭발적으로 늘어난다는 이론인데요. TypeSafe가 노리는 것도 바로 이것입니다. 지능의 가격이 10배 저렴해지면, 지능이 쓰이는 곳은 100배 늘어날 거라는 베팅이죠.
같은 메시지에 두 모델은 어떻게 답할까?
온라인 쇼핑몰을 운영 중인데 고객센터로 이런 문의가 접수되었다고 가정해 볼게요:
“새 이어폰을 샀는데 박스가 완전히 찌그러져서 왔고, 왼쪽 이어폰에서 소리가 안 나요. 당장 환불해 주세요.”
일반 LLM에 던지면 이런 긴 문장으로 답해옵니다:
“해당 문제는 상품 불량 및 배송 파손과 관련이 있으며 고객의 분노도가 높으므로 우선 처리 및 환불 절차를 진행할 것을 권장합니다.”
문장은 훌륭하지만, 프로그램 코드가 바로 이해할 수는 없죠. 다시 이 문장을 파싱하는 정규식을 짜거나 JSON 출력을 유도해야 하고, 모델이 엉뚱한 쉼표를 찍거나 없는 필드를 지어내지 않길 기도해야 합니다.
소프트웨어 프로그램에 정말 필요한 값은 딱 세 개예요: 어떤 분류인가, 고객이 얼마나 화가 났는가, 환불 요청인가. Jev는 이 세 가지 값과 각각의 확률을 즉시 뱉어냅니다.
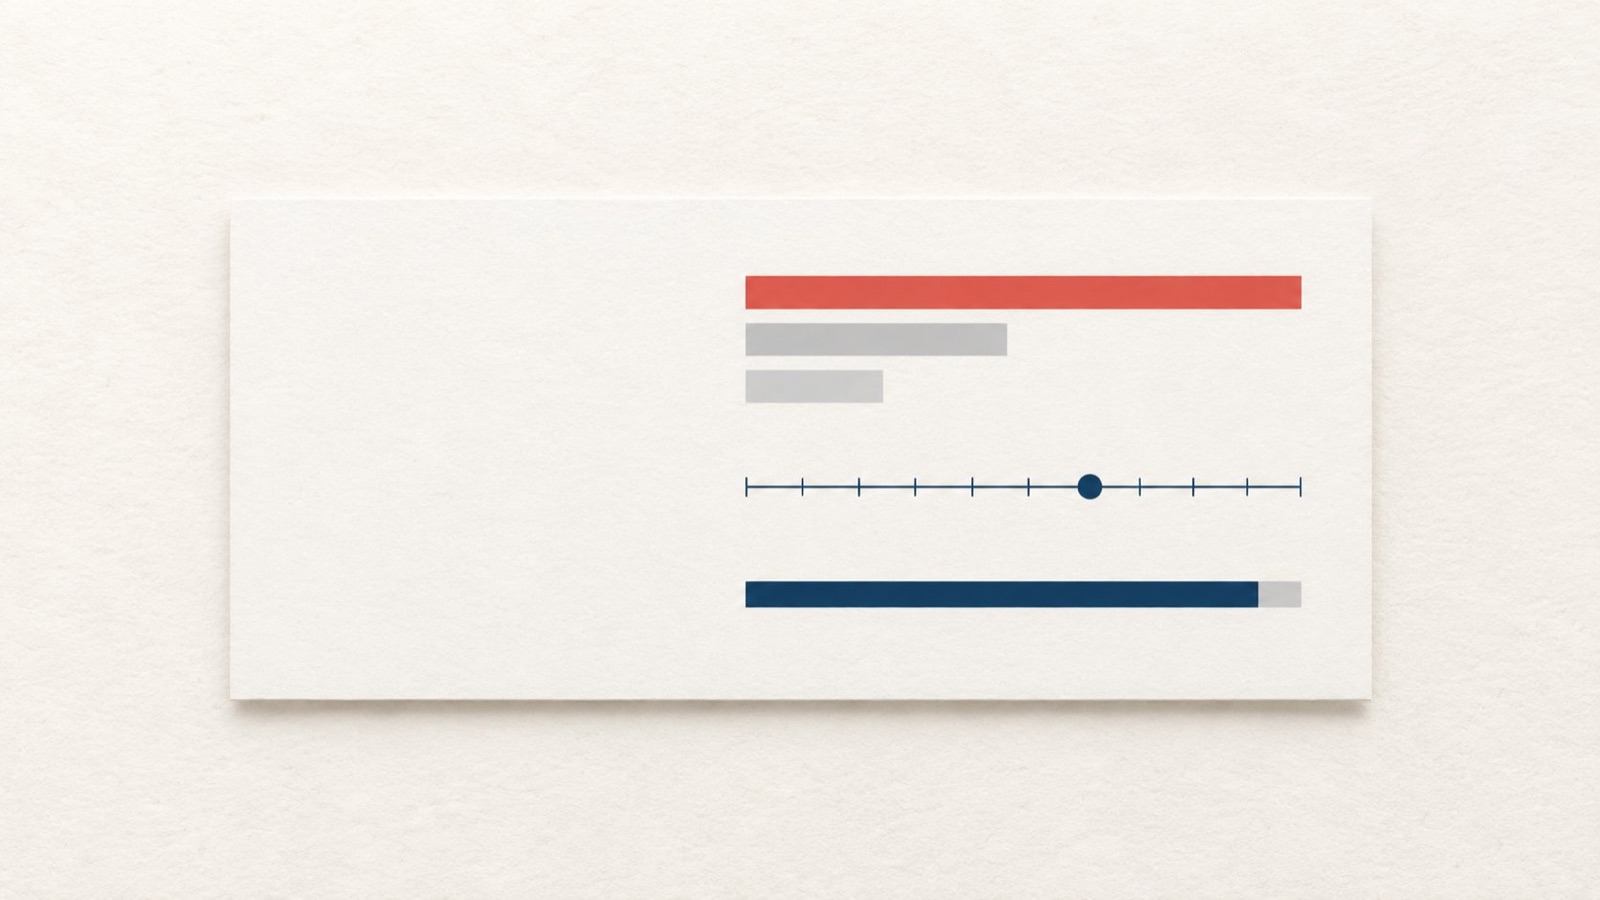
선택지는 개발자가 미리 정의해 둔 것이고, 모델은 오직 그 안에서만 고릅니다. 쓸데없는 미사여구를 늘어놓지도 않고, 개발자가 정의하지 않은 엉뚱한 카테고리를 지어내지도 않아요.
단 세 종류의 문제 유형
Jev의 인터페이스는 의도적으로 딱 세 가지 유형의 문제만 지원합니다.
첫 번째는 Choice(단일 선택): 보기 목록(최대 255개) 중 하나를 선택합니다. 예컨대 ‘이 티켓을 재무팀, 기술팀, 영업팀 중 어디로 배정할까?’ 같은 문제입니다. 팁을 주자면 항상 ‘기타(Other)’ 보기를 넣어두는 게 좋아요. 딱 들어맞는 보기가 없을 때 억지로 가장 그럴듯한 오답을 찍는 현상을 방지할 수 있거든요.
두 번째는 Score(점수 평가): 텍스트로 기준 단계들을 지정해 주면 그 사이 어디쯤 위치하는지 알려줍니다. 1.035 같은 소수점 값으로 반환돼요. 예컨대 ’고객의 화난 정도’를 평온함부터 참으면서 불만인 상태, 극도로 격분한 상태까지 단계별로 매길 수 있습니다.
세 번째는 Noul(진위 판단): 예/아니오를 판단하여 0에서 1 사이의 값(즉 ’예’일 확률)을 바로 넘겨줍니다.
한 번의 API 요청에 수많은 문제를 한꺼번에 담을 수 있어요. 문제들은 모두 병렬로 동시에 계산되기 때문에 질문을 몇 개 더 추가해도 비용은 아주 미미하게 늘고 시간은 거의 차이가 없습니다.
실제 코드는 어떤 모습일까?
공식 Python 및 TypeScript SDK가 제공됩니다. 위에서 든 고객센터 문의를 코드로 작성하면 대략 이런 모양새가 돼요.
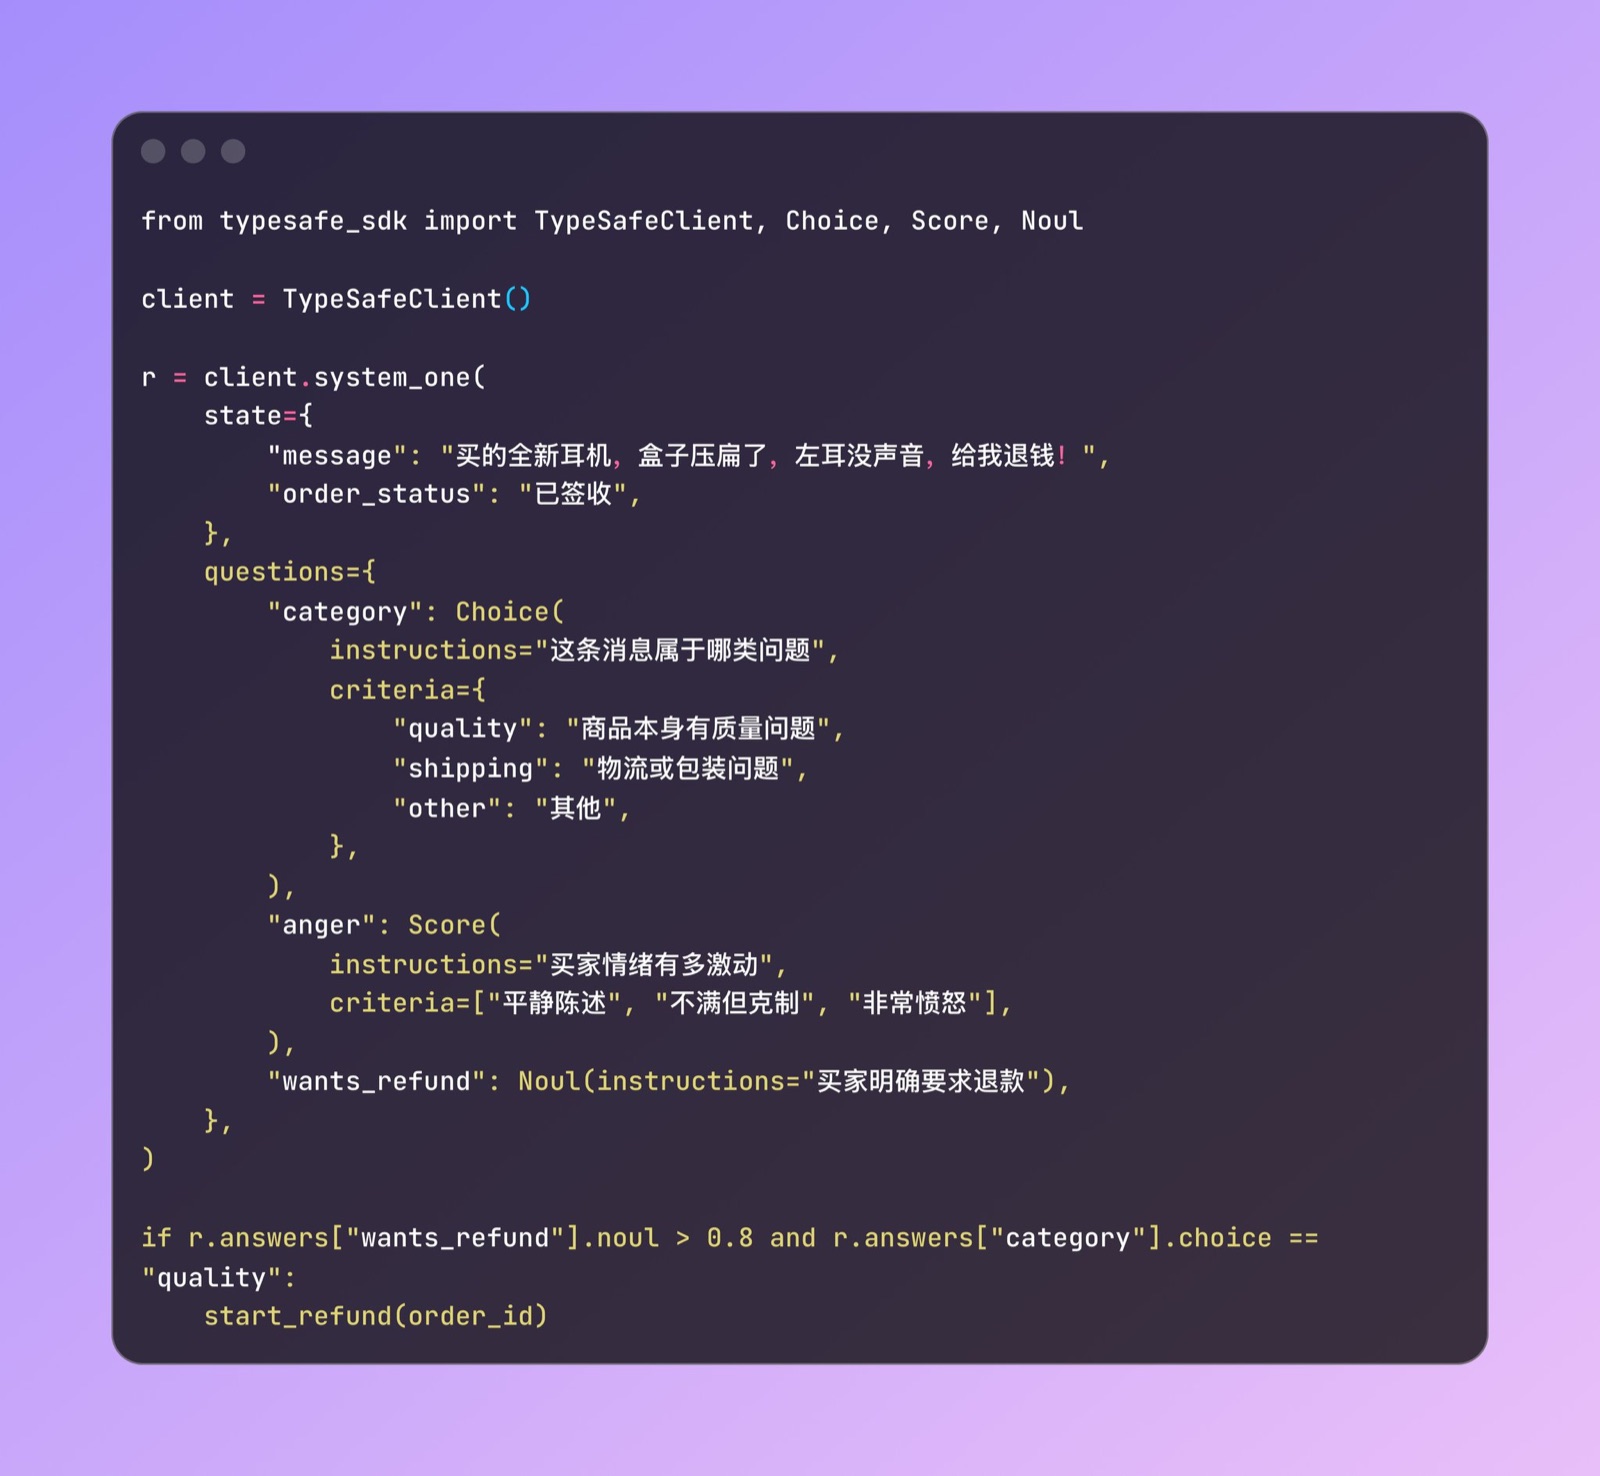
핵심은 맨 마지막 if 문입니다. Jev는 순수하게 판단만 할 뿐이고, 실제로 환불을 해줄지 얼마를 돌려줄지는 여러분의 고유 코드가 결정합니다. 공식 문서에서는 이를 **스마트 if 문(Intelligent if statement)**이라고 불러요. 지금까지 규칙화하기 어려웠던 모호한 정성적 판단들을 이제 코드 속 if 조건문 안에 자연스럽게 녹여낼 수 있게 된 거죠.
왜 이렇게 빠른가?
일반 LLM이 JSON을 출력할 때도 토큰을 하나하나 순차적으로 생성해야 합니다. 중괄호, 큰따옴표, 키 이름까지 매번 순차적으로 연산해야 하고, 다음 토큰은 이전 토큰이 나와야만 계산할 수 있어요. 반면 Jev는 글자 생성을 아예 하지 않고 모든 문제의 확률을 단번에 병렬 연산합니다. 공식 측에서는 End-to-End 지연 시간이 70~500ms라고 밝혔어요. 같은 벤치마크 표에서 일반 프론티어 LLM들은 3초에서 300초 이상 걸렸습니다.
가격은 더 극단적입니다. 입력 백만 토큰당 0.042달러 수준이에요.
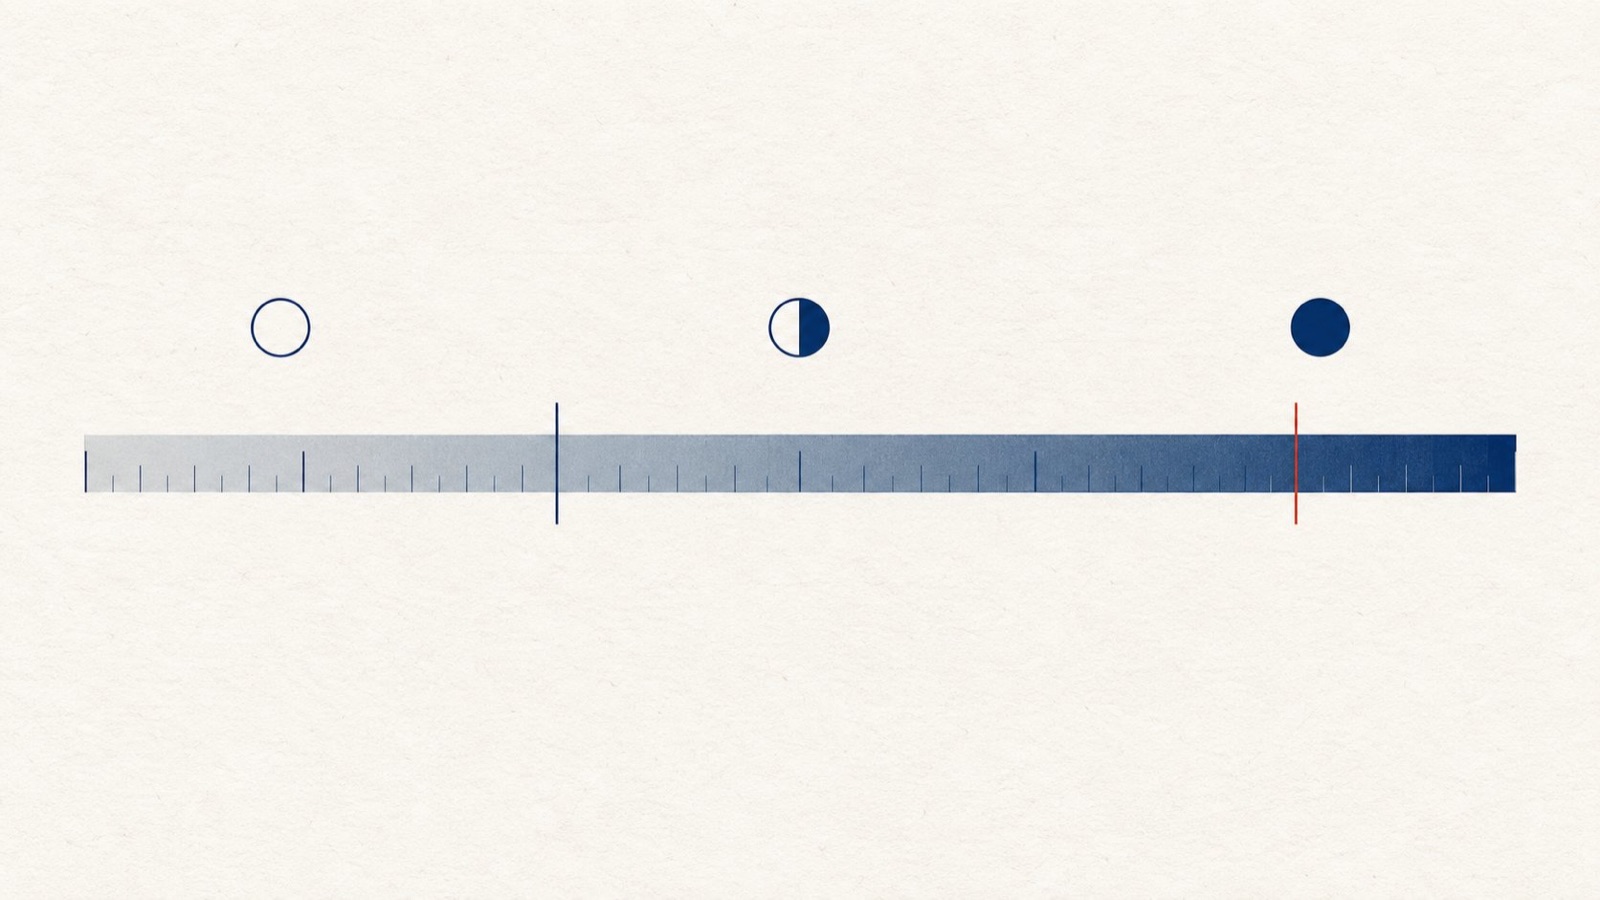
일반 대형 모델에게도 ’얼마나 확신하는지 확률을 말해줘’라고 프롬프트를 짤 수 있지만, 걔들은 대개 근자감이 넘치죠. 말로는 95% 확신한다고 해놓고 틀리는 경우가 허다합니다.
사람들은 이걸로 무엇을 만들었나?
출시 이틀 만에 커뮤니티에서 재미있는 프로젝트들이 쏟아져 나왔어요 (수치는 제작자들의 자체 보고 기준입니다):
- 논문 1,018편 분류: 먼저 DeepSeek V4 Flash로 요약을 뽑는 데 3.99달러가 들었는데, 그 요약문들과 24개 주제를 Jev에게 던져 단일 선택으로 분류하는 데는 총 0.08달러밖에 들지 않았습니다.
- 브라우저 에이전트(Browser Use 팀): 매 단계 웹페이지를 번호 매겨진 요소 목록으로 변환하고, Jev가 한 번의 요청으로 어떤 동작을 취할지 어떤 요소를 클릭할지 동시에 판단합니다. 타이핑이 필요할 때만 작은 모델을 호출해요. 실제 Google Flights에서 취리히-런던 항공권을 예약하는 데 7.1초, 비용은 0.0039달러가 들었습니다.
- Mac 화면 자동화: OCR로 화면을 읽고 Jev가 다음 단계를 선택하도록 구성해 스텝당 0.0002달러를 썼습니다. Opus 5로 스크린샷을 직접 보게 했을 때는 스텝당 0.032달러였죠. (물론 대형 모델은 스크린샷만 보고도 날짜 선후를 파악하지만, Jev를 쓸 때는 이 부분을 코드로 직접 처리해야 했다는 솔직한 후기도 덧붙였습니다.)
- 드론 제어 및 게임 플레이: 비행 제어와 장애물 회피는 전통적인 코드로 처리하고 컴퓨터 비전도 전통 CV를 쓰면서, Jev는 초당 2.5회 정성적 판단 제안만 하도록 했습니다. 안전 제어는 항상 하드웨어 코드가 쥐고 있는 식이죠. 스타크래프트 1번째 미션을 421회 의사결정으로 클리어하거나 슈퍼마리오 에뮬레이터 메모리 JSON을 분석해 게임을 플레이하게 만든 사례도 나왔습니다.
이 모든 프로젝트의 공통점은 루프, 안전성, 복잡한 계산은 일반 코드에 맡기고, 코드로 딱 떨어지게 짜기 힘든 중간의 작은 판단 영역만 Jev에게 맡겼다는 점이에요.
Jev의 한계와 주의점
TypeSafe 공식 문서에는 Jev가 못하는 것들을 따로 모아둔 페이지가 있는데, 런칭 시점부터 이런 한계를 솔직하게 공개한 건 인상적입니다.
- 지나치게 문자 그대로만 해석함: 부정어, 범위 한정, 사람이 머릿속으로 암묵적으로 전제한 조건들을 철저히 글자 그대로만 받아들입니다. 만약 “사실 내 의도는 이런 거였는데…“라는 생각이 든다면, 그 의도가 질문에서 누락되었기 때문이에요.
- 숫자를 세지 못함: 개수가 많아질수록 정확도가 급격히 떨어집니다. 개수를 세어야 한다면 각 항목마다 ’해당되는가?’를 물어보고 마지막에 코드로 합산해야 해요.
- 날짜 계산 불가: 누가 앞서고 며칠 차이가 나는지 계산하지 못합니다. 날짜 텍스트를 추출하는 것까지만 시키고 비교는 코드가 해야 해요.
- 무관한 데이터가 많을수록 부정확해짐: 질문과 무관한 필드가 많으면 엉뚱한 답을 낼 확률이 높아집니다. 질문에 필요한 필드만 코드로 미리 정제해서 전달하는 게 좋습니다.
- 프롬프트 인젝션 취약: 사용자가 입력을 조작할 수 있는 환경이라면 교묘하게 작성된 문장에 의해 판단이 왜곡될 수 있습니다.
- 생성 능력 전무: 텍스트, 코드, 요약 등 그 어떤 것도 생성해 내지 못합니다.
공식 문서에 나오는 문장 중 마음에 드는 구절이 있어요: “코드로 정확히 계산할 수 있는 건 모델에게 묻지 말고, 한 질문 안에 여러 판단을 숨겨두지 마라.”
’200배 빠르다’는 수치를 어떻게 봐야 할까?
여러 글에서 100배, 200배, 400배 등 다양한 수치를 보셨을 텐데요. 가장 높은 193.6배 빠르고 444.6배 저렴하다는 수치는 TypeSafe 자체 벤치마크 결과이며, 현실적인 조건 중에서도 꽤나 유리한 상황을 가정한 수치입니다.
벤치마크에서 Jev는 67.8%를 기록했고 GPT-5.6 Terra는 67.9%로 거의 같았습니다. Sol(74.1%), Opus 5(73.1%)가 더 높았고, Claude Sonnet 5도 67.8%였지만 문제당 비용은 Jev보다 293배 비쌌어요.
하지만 이 점수가 절대적인 정답률은 아닙니다. 이 테스트에는 표준 정답이 없었고, GPT-6 Astra와 Fable 5.1의 평균치를 정답 기준으로 삼았어요. 즉 ’이 두 최상위 모델의 판단과 얼마나 유사한가’를 측정한 것이고, 문제 출제와 테스트 모두 자사가 진행한 것이라 아직 제3자 검증이 필요합니다.
또한 ’환각이 없다’는 표현도 걸러 들어야 해요. 답이 반드시 주어진 선택지 안에서만 나온다는 뜻이지, 선택지 중에서 엉뚱한 답을 고르는 오판 자체가 없다는 뜻은 아니거든요. 가격 역시 현재 프로모션/보조금 단계일 수 있어 앞으로 변동될 수 있습니다.
비판적인 시각
엔지니어 숀 괴데케(Sean Goedecke)의 분석 글이 꽤 설득력 있습니다. 그는 기존 대형 모델들도 출력 토큰을 1개로 제한하고 선택지 로짓만 읽어들이는 방식으로 최적화하면 비슷한 속도 이점을 상당 부분 얻을 수 있다고 지적했어요. 실제로 Qwen2.5-1.5B로 테스트해 본 결과 기존 구조화 출력보다 2~3배 빨라졌다고 합니다.
커뮤니티에서는 이 아이디어를 발전시켜 4B 오픈소스 모델 기반으로 선택지 확률을 한 번에 읽는 ’openjev’라는 오픈소스 프로젝트를 내놓기도 했습니다. (물론 인터페이스 복제일 뿐 Jev 고유의 모델이나 훈련 방식은 아닙니다.)
또한 Jev는 사고 시간(Test-time compute)을 투입할 수 없어 추론 능력이 비추론 계열 소형 모델 수준에 머뭅니다. 따라서 기술적 해자가 얼마나 깊은지는 더 지켜봐야겠지만, 이 목적 하나만을 위해 특화 훈련된 모델이 범용 모델 튜닝보다는 확실히 다루기 편하다는 점은 인정받고 있어요.
언제 써야 하고, 언제 쓰지 말아야 할까?
적합한 곳:
- 고객센터 티켓 분류 및 자동 라우팅
- 콘텐츠 모니터링 및 유해성 검사
- 비싼 대형 모델에 입력하기 전 사전 필터링
- LLM 출력물의 품질 점수 매기기 및 가드레일
- 비용 문제로 엄두를 못 내던 대규모 데이터 라벨링
- 1초 안에 결과가 나와야 하는 모든 실시간 판별 로직
부적합한 곳:
- 글, 코드, 요약문 작성
- 수량 세기나 날짜 비교
- 사용자에게 근거 이유를 설명해야 하는 의사결정
- 일회성의 복잡한 다단계 논리 추론
- 선택지를 미리 정의할 수 없는 개방형 질문
가장 보편적인 아키텍처는 계층형 라우팅입니다. Jev가 요청의 난이도를 1차 판단해서, 코드로 될 것은 즉시 처리하고, 보통 난이도는 가벼운 모델로 보내고, 정말 어려운 소수의 작업만 최상위 모델로 전달하는 구조예요. LangChain에서도 이미 연동 튜토리얼을 냈는데, 에이전트의 도구 호출(Tool Calling)에 위험 요소가 있는지 검사하는 가드레일 용도로 Jev를 활용하고 있습니다.
직접 써보고 싶다면 현재 대기자 명단에 등록해야 하며, Vercel AI Gateway를 통해서도 호출할 수 있습니다. 확신도 임계값을 조율해 두었다면 모델 버전명을 고정해 두세요. jev-latest는 업데이트에 따라 판단 경향이 달라질 수 있습니다.
개인적인 감상
Jev에서 가장 인상 깊었던 점은 ’인터페이스의 전환’이었습니다. 지난 몇 년간 LLM 기반 애플리케이션은 대부분 챗봇 창의 형태를 벗어나지 못했는데, 100ms 만에 응답하고 비용이 거의 들지 않으며 신뢰도 점수까지 주는 판단 함수가 생기면서, 챗봇과는 전혀 다른 형태의 새로운 AI 서비스들이 등장할 수 있는 길이 열렸습니다.
우리가 과거에 대형 모델에게 시켰던 일 중 상당수는 사실 객관식 문제에 불과했다는 점을 일깨워주기도 하네요. 아직 베타 기간이고 핵심 수치도 자체 테스트인 만큼, 써드파티 검증 결과를 차분히 지켜보며 도입을 검토해 보면 좋을 것 같습니다.
여러분이 지금 만들고 있는 기능 중에도, 알고 보면 AI에게 객관식 문제 하나만 풀게 하면 끝나는 작업이 있지 않으신가요?